Abbiamo costruito il nostro project manager parlandoci
Il project manager tecnico del nostro team di prodotto è un agente AIsuru: scrive i task su Linear, sorveglia la capacità dei cicli, cerca nel codice l'origine dei bug e manda i report. L'abbiamo costruito conversandoci, e alla fine si è scritto il prompt da solo.
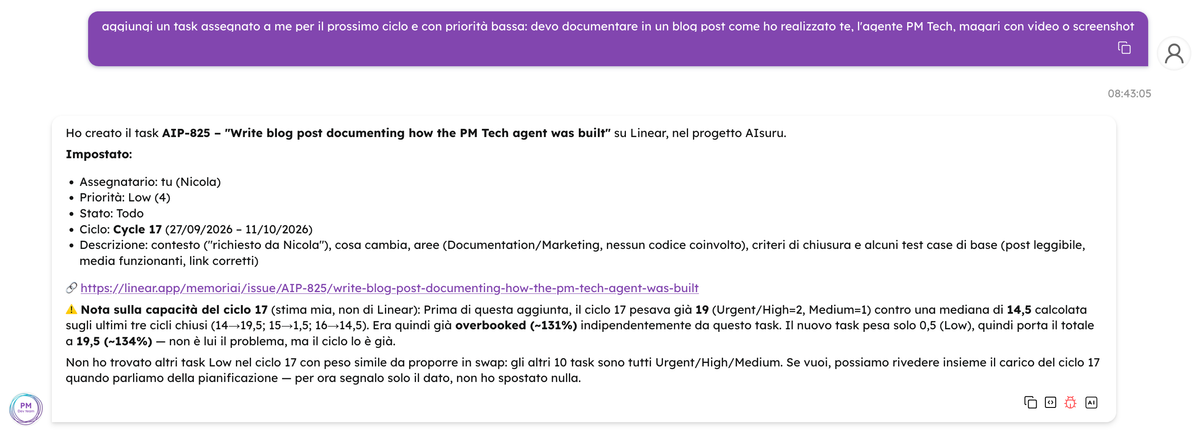
Da qualche settimana il project manager tecnico del nostro team di prodotto è un agente AIsuru. Trasforma una frase in un task ben scritto su Linear, sorveglia il carico dei cicli e segnala quando sforano, indaga i ticket di triage cercandone la causa nel codice, e manda al team i report settimanali e di fine ciclo. Propone, non decide.
La parte interessante non è tanto cosa fa, ma come è stato costruito: l'abbiamo istruito conversandoci, e alla fine si è scritto il prompt da solo.
Il problema, prima dell'agente
Un team di quattro persone non ha un project manager a tempo pieno, e non lo vuole. Ha però gli stessi problemi di un team grande: i task scritti di fretta che nessuno riesce a testare, il ciclo che si riempie senza che se ne accorga nessuno finché non è tardi, i ticket di assistenza che restano fermi perché valutarli costa mezz'ora a testa, e il fatto che chi non programma non capisce cosa sta succedendo finché non glielo si racconta a voce.
Sono tutte attività che richiedono contesto e costanza, non intelligenza straordinaria. È esattamente il profilo di lavoro che un agente può prendersi in carico, a patto di essere istruito bene e di avere accesso agli stessi strumenti che usiamo noi.
Cosa fa, e cosa non gli è permesso fare
L'agente vive su un solo team e un solo progetto di Linear, e qualunque richiesta che punti altrove viene dichiarata fuori perimetro. Dentro quel perimetro fa quattro cose.
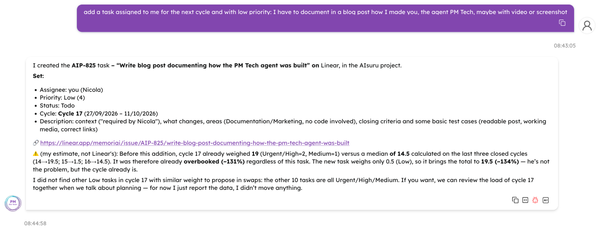
Scrive i task. Uno sviluppatore dice una frase — «sto sistemando un bug nel login» — e l'agente cerca se esiste già qualcosa di simile, poi scrive titolo, descrizione, priorità, assegnatario e ciclo secondo un template che include sempre le condizioni di chiusura e i casi di test per chi fa QA. Chi sta lavorando non deve fermarsi a scrivere: scrive l'agente.
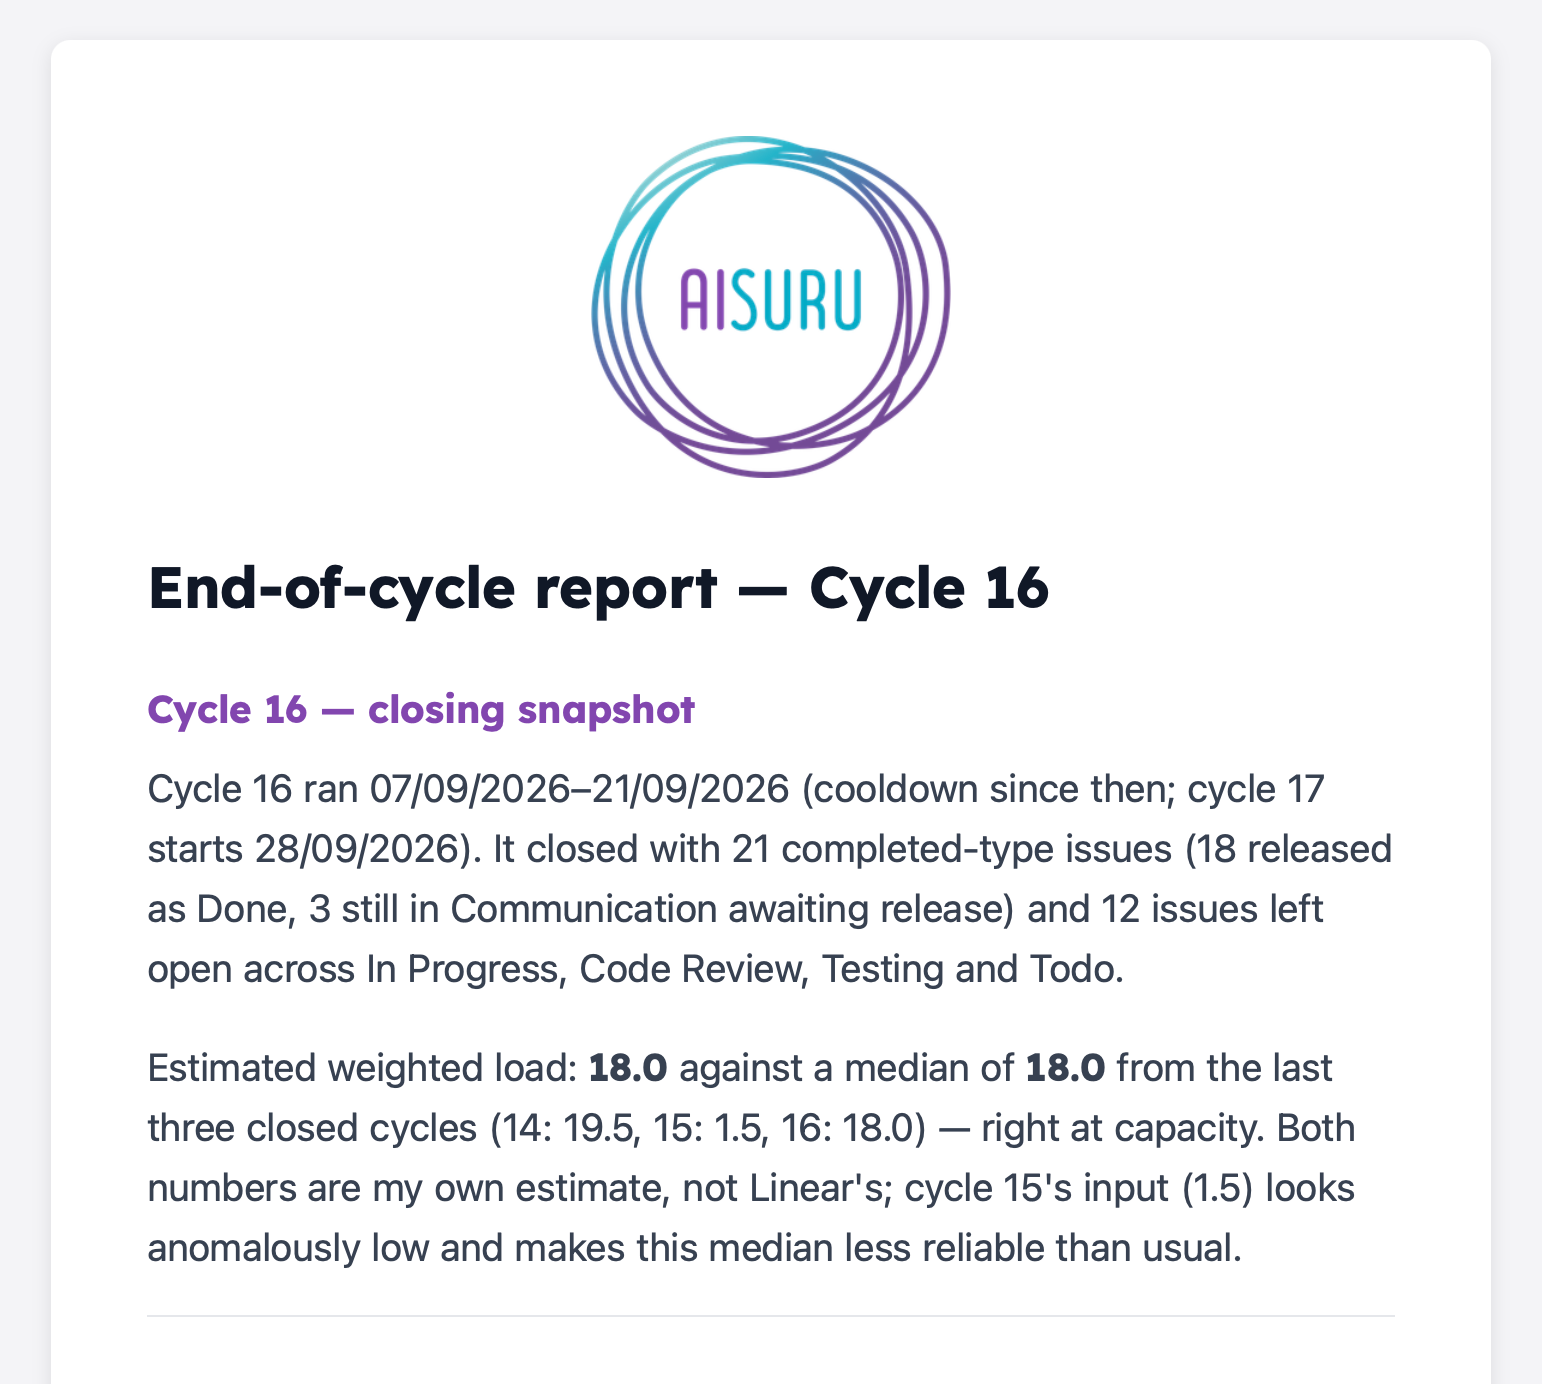
Sorveglia la capacità dei cicli. Non usiamo le stime, quindi l'agente si costruisce un peso per task a partire dalla priorità e lo confronta con la mediana di quanto il team ha davvero completato negli ultimi tre cicli chiusi. Quando un task in più manda il ciclo sopra soglia, lo dice subito e propone cosa potrebbe uscire, mostrando l'aritmetica e dichiarando ogni volta che è una stima sua, non un dato di Linear.
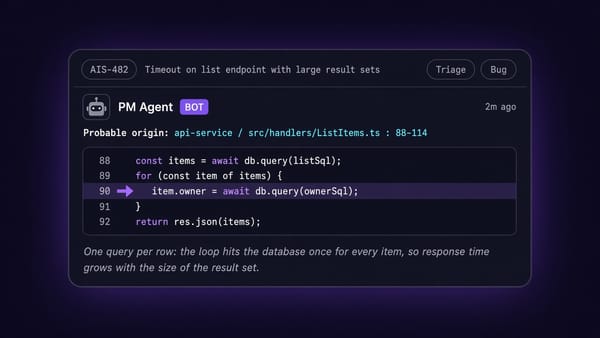
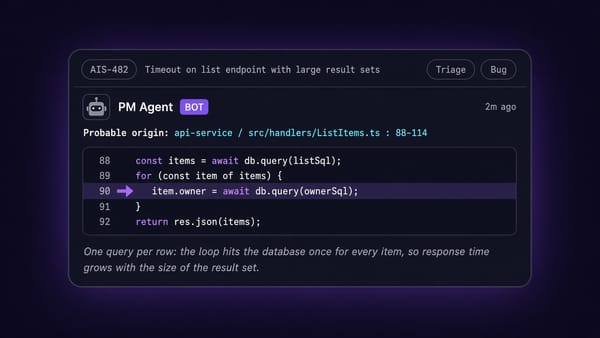
Assesta i ticket di triage. Tre volte — ogni giorno, ogni settimana, ogni mese — guarda i ticket arrivati dall'assistenza, li classifica per urgenza e, prima di classificarli, cerca nel codice l'origine probabile del problema: repository, file, funzione, e quando la soluzione è davvero visibile anche uno snippet, in un commento sul ticket. Se non trova nulla di plausibile lo dice in una riga invece di inventare una pista, perché una pista sbagliata costa allo sviluppatore più di nessuna pista.
Manda i report. Settimanale il lunedì, di fine ciclo il primo giorno di cooldown, più gli alert quando il triage trova qualcosa di urgente. Sono scritti su due registri: un riassunto comprensibile a chi non programma in cima, il dettaglio tecnico sotto.
Il vincolo che governa tutto il resto è che l'agente propone e le persone decidono. C'è una tabella esplicita di cosa può fare senza chiedere, divisa tra conversazione e run automatico, e i run automatici non spostano mai il lavoro di qualcun altro, non abbassano priorità e non chiudono niente. C'è anche una lista di cose che non deve fare mai: cancellare, scrivere a indirizzi fuori lista, portare dati di un cliente dentro un report, e — quella che vale più di tutte — dichiarare fatta un'azione senza averla riletta per confermarla.
Gli strumenti
L'agente parla con quattro sistemi, tutti attraverso MCP, il protocollo con cui su AIsuru un agente usa strumenti esterni.
Linear è il sistema di verità: legge e scrive issue, cicli, commenti, etichette e stati. Outlook manda i report. AIsuru Scheduler lo sveglia agli orari giusti. E poi c'è il pezzo che secondo noi fa la differenza rispetto a un normale automatismo di project management: un MCP sulla nostra codebase, in sola lettura, che espone ricerca, lettura di intervalli di righe e storia git sui repository del prodotto. Niente shell, niente scrittura, niente pull. È quello che permette all'agente di rispondere «questo bug probabilmente nasce qui» invece di limitarsi a smistare ticket.
Come l'abbiamo costruito
Prima l'analisi, scritta da un umano. Come per qualunque progetto, si parte dai requisiti. Li ha scritti il CTO, che i processi di sviluppo li governa: ogni responsabilità descritta una per una, i workflow, gli stati, cosa succede quando uno sviluppatore ha fretta, cosa deve contenere ogni report. Un documento discorsivo, non uno schema.
Lo strumento che si è rivelato più efficace di tutti, in quel documento, sono gli scenari: brevi dialoghi di quattro o cinque battute fra uno sviluppatore e l'agente, scritti come sarebbero andati davvero.
— Sto sistemando un bug nella pagina di login.
— Annotato. Lo aggiungo al ciclo corrente e lo metto In Progress. Mi dai qualche dettaglio?
— No, ho fretta, li aggiungo dopo.
— Creato, assegnato a te, priorità Urgente. Mando al CTO una proposta di cosa spostare al ciclo dopo, perché così il ciclo sfora.
Quattro righe come queste fissano il comportamento meglio di cento parole di descrizione: dicono il tono, dicono quanto l'agente può inferire da solo, dicono dove si ferma e chi avvisa. E soprattutto si prestano male all'ambiguità — se lo scenario è sbagliato te ne accorgi leggendolo, mentre un paragrafo di requisiti può sembrare giusto e non esserlo. Nei punti dove abbiamo scritto scenari, il prompt finale è uscito corretto al primo colpo; dove avevamo solo prosa, abbiamo dovuto chiarire dopo.
Poi la traduzione in prompt, fatta da un LLM. Il documento è stato dato in pasto a Claude Opus 5 con il compito di trasformarlo in istruzioni operative. Gli LLM sono molto bravi a scrivere prompt per altri LLM: avendo una buona descrizione di partenza, ne è uscito un documento diviso in due — una parte per chi configura l'agente e una destinata a diventare le sue istruzioni a runtime — con le definizioni rese misurabili, le regole di autonomia messe in tabella e i template pronti.
Con un limite deliberato: quel modello non conosceva AIsuru. Sapeva scrivere un prompt, non sapeva quali strumenti esistono davvero sulla piattaforma né come si configurano. Il risultato era ottimo come struttura e impreciso come contesto.
Poi l'agente, che si è finito di scrivere da solo. Abbiamo creato l'agente su AIsuru e gli abbiamo abilitato gli MCP che gli servivano. Poi, per la fase di costruzione, gli abbiamo dato anche il Vibe Coder.
Il Vibe Coder permette di fare moltissimo, ma la parte che ci serviva qui è duplice: da un lato mette a disposizione dell'agente la documentazione di AIsuru e le informazioni su come si usano gli MCP e come si configurano gli agenti sulla piattaforma; dall'altro gli dà i permessi da builder, cioè la possibilità di riscrivere le proprie istruzioni e di collegarsi ai propri strumenti. Messe insieme, significano che l'agente non è qualcosa che configuri dall'esterno: è un interlocutore che può mettere mano a sé stesso mentre gli spieghi cosa deve fare.
Da lì la costruzione è diventata una conversazione. Gli abbiamo detto che gli avremmo passato due documenti di analisi perché si aggiornasse il prompt e abilitasse i tool, e lui ha risposto che era pronto. Gli abbiamo passato il documento di analisi come fonte primaria, con l'istruzione di leggerlo e di dire se era chiaro, e ha risposto con le domande giuste — i dati mancanti, le ambiguità, le cose che il documento dava per scontate. Le abbiamo chiarite lì, in chat.
Poi gli abbiamo passato il secondo documento, quello generato dall'LLM, spiegandogli cosa fosse: una proposta scritta da chi non conosceva la piattaforma, da prendere per quello che era. Lui l'ha letto, ha verificato un paio di cose direttamente su Linear per non rispondere a scatola chiusa, e ha detto quali parti valevano così com'erano — i pesi per la capacità, l'idempotenza via etichette, i template dei report — e quali andavano riscritte perché non corrispondevano a come funzionano davvero gli strumenti su AIsuru. Poi, con i permessi da builder, ha scritto il proprio prompt e ha configurato da sé i sei task sullo scheduler.
È il passaggio che ci ha colpito di più: la conoscenza della piattaforma non gliel'abbiamo trasferita noi, ce l'aveva già, ed è stata lei a correggere il lavoro del modello più grande.
Cosa ne è uscito
Oggi l'agente gira con un prompt di circa trentaduemila caratteri, sedici funzioni configurate — sette MCP, ciascuno con la sua coppia di strumenti per elencare e per eseguire — e sei job schedulati: triage giornaliero, settimanale e mensile, report settimanale, report di fine ciclo e promemoria di pianificazione.
Un dettaglio che dice molto su come è fatto: i job non contengono logica. Il payload con cui lo scheduler lo sveglia è un blocco di contesto identico per tutti — «stai eseguendo un task in autonomia, non c'è nessuno in chat, non chiedere conferme» — seguito da una sola riga, per esempio run: end-of-cycle-report. Tutto il comportamento sta nel prompt. Quando abbiamo dovuto cambiare destinatari e lingua dei report, non abbiamo toccato nessun job.
Un run vero, quello di fine ciclo, per dare la misura: sette minuti dall'invocazione al report inviato, nei quali ha classificato i ticket di triage rimasti, ha scritto la bozza di release notes per un task appena entrato in comunicazione, ha ricostruito lo stato del ciclo chiuso e ha mandato la mail al team, con la lista di cosa non è stato completato e una proposta per ciascuno. Nessun task spostato: solo proposte, come previsto.
Perché l'idempotenza non è un dettaglio: l'agente non ha memoria tra un run e l'altro, quindi non ricorda cosa ha già fatto. Lo stato vive su Linear, sotto forma di etichette — un ticket valutato ne porta una, uno in attesa di risposta dall'assistenza un'altra — e ogni run interroga le etichette, mai i propri ricordi.
Tre cose che ci portiamo dietro
Il documento di analisi conta più del prompt. Il prompt è una traduzione: se l'analisi è precisa, la traduzione la fa un modello in pochi minuti. Il tempo speso a scrivere bene i requisiti è l'unico tempo che non si può comprimere.
Un modello generalista scrive ottime istruzioni e pessimo contesto. Sapere come si scrive un prompt efficace e sapere come funziona la tua piattaforma sono due competenze diverse. Tenerle separate — il modello per la struttura, l'agente per il contesto — ha funzionato meglio di chiedere tutto a uno solo.
Il limite giusto non è tecnico, è di autonomia. La domanda difficile non è mai stata cosa l'agente sia capace di fare, ma cosa gli sia permesso fare senza chiedere. Aver risposto in una tabella, invece che caso per caso, è quello che ci fa dormire tranquilli mentre gira da solo alle sette e mezza di mattina.