Dare la codebase in lettura a un agente, senza dargli il server
Un connettore MCP che espone i repository in sola lettura, su una macchina dedicata. Perche' la strada comoda non va bene, com'e' fatto il modello di permessi, e cosa puo' fare davvero l'agente.
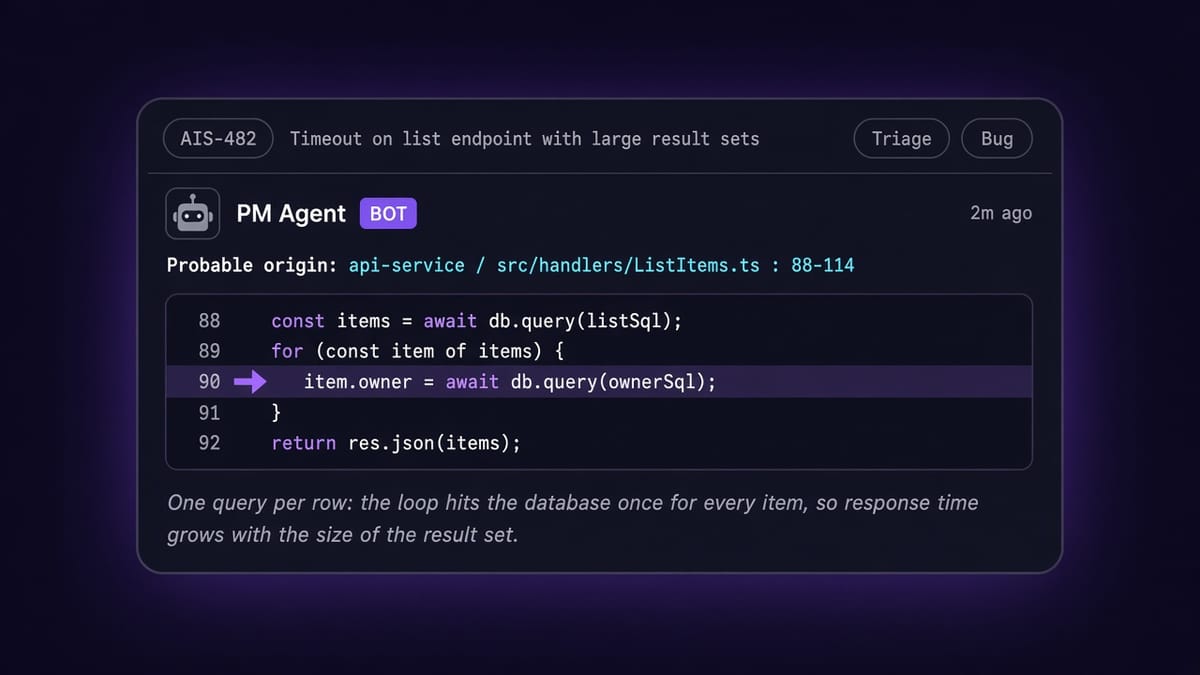
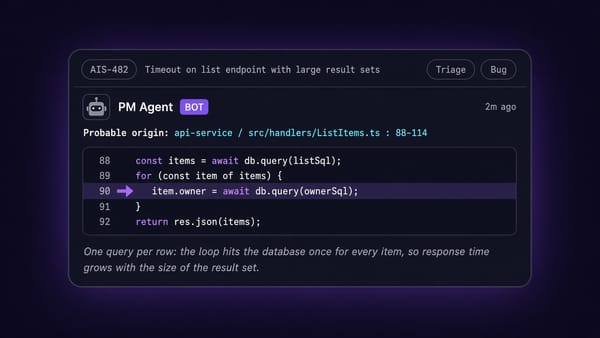
Quando abbiamo costruito il nostro project manager, la cosa che lo ha reso davvero utile non è stata l'integrazione con Linear. È stata la possibilità di rispondere «questo bug probabilmente nasce qui», con il nome del file e le righe giuste, mentre classifica un ticket arrivato dall'assistenza. Per farlo, un agente deve poter leggere il codice del prodotto.
Detta così sembra banale: si dà accesso al repository e via. Il punto è che come si dà quell'accesso decide tutto il resto, e il modo comodo — quello in cui l'agente esegue comandi su una macchina che ha già il codice — è anche il modo in cui, il giorno che qualcosa va storto, non hai nessuna barriera fra un prompt e la tua base di codice.
Abbiamo quindi scritto un connettore MCP dedicato, che gira su un server suo, e il cui unico scopo è esporre i repository in sola lettura. Questo post racconta com'è fatto e soprattutto perché è fatto così.
Il problema con la strada comoda
Il protocollo MCP prevede che un server possa essere avviato in locale dal client stesso. È la modalità con cui la maggior parte dei connettori viene provata, ed è perfetta per lo sviluppo: zero infrastruttura, parte e funziona.
Applicata al codice sorgente, però, quella strada ha tre conseguenze che è meglio guardare in faccia. Il processo eredita l'identità di chi lo ha avviato, quindi vede tutto quello che vede quell'utente, non solo il codice. Convive con il resto della piattaforma, cioè con le credenziali e con le connessioni verso gli altri servizi. E il codice sorgente deve trovarsi lì, in mezzo a tutto il resto.
Tre proprietà che singolarmente si tollerano e che insieme descrivono esattamente quello che non vuoi: un componente che legge file, guidato da un modello linguistico, in esecuzione dove tieni i segreti.
Un host dedicato, e due utenti che non si fidano l'uno dell'altro
Il connettore gira quindi su una macchina sua, il cui unico compito è quello. Sull'host non c'è nient'altro di interessante da raggiungere, e questo cambia la domanda di sicurezza: non più «cosa può toccare questo processo su una macchina piena di roba», ma «cosa c'è su questa macchina». La risposta è: copie di sola lettura di alcuni repository, e nient'altro.
Sull'host la separazione prosegue, ed è il cuore del modello di permessi. Ci sono due utenti di sistema, entrambi senza possibilità di fare login, con due ruoli deliberatamente incompatibili.
Il primo possiede le copie del codice e le chiavi di accesso ai repository, ed è l'unico che parla con l'esterno: ogni poche ore aggiorna gli alberi di lavoro, e non fa nient'altro. Il secondo esegue il connettore, non ha privilegi amministrativi, non possiede nessuna chiave, e sul codice ha esclusivamente il permesso di lettura, perché i file appartengono al primo utente e al secondo arrivano attraverso un gruppo di sistema che dà appunto solo la lettura.
La conseguenza è la parte che ci interessa. Anche ammettendo che qualcuno riesca a far fare al processo MCP qualcosa che non dovrebbe, quel processo non ha il diritto di scrivere sul codice e non possiede le credenziali per parlare con i repository remoti. Non è una regola applicativa che si può aggirare con un bug: è il filesystem, ed è il livello che sta sotto qualunque cosa faccia l'applicazione. Il servizio viene inoltre avviato con le protezioni che il sistema operativo mette a disposizione — niente escalation di privilegi, niente accesso alle home, e l'albero del codice montato in sola lettura — così che anche i permessi sbagliati troverebbero comunque un rifiuto un gradino più sotto.
Un dettaglio dell'aggiornamento periodico vale la pena di raccontarlo, perché è una decisione e non un caso: subito dopo aver scaricato le novità, la procedura cancella i file di configurazione locale dalle copie di lavoro, tenendo solo i template di esempio. Il codice che l'agente legge è il codice, non la configurazione con i segreti dentro. Se uno di quei file finisce per sbaglio in un repository, il giro successivo lo toglie di mezzo.
Gli strumenti, uno per uno
Il connettore espone otto strumenti, e sono tutti verbi di lettura.
| Strumento | Cosa fa |
|---|---|
codebase_list_repos | Elenca i repository disponibili, con ramo e commit corrente |
codebase_tree | Mostra file e cartelle sotto un percorso, a profondità contenuta |
codebase_search | Cerca un pattern nel contenuto e restituisce percorso, riga e frammento |
codebase_read | Legge una finestra di righe di un file, non il file intero |
codebase_git_log | Storia dei commit, filtrabile per autore, data o percorso |
codebase_git_show | Contenuto di una revisione: un commit, un tag, un file a una certa revisione |
codebase_git_diff | Differenze fra due riferimenti |
codebase_status | Da quanto tempo i dati non vengono aggiornati, e a che punto è ogni repository |
Non c'è uno strumento che esegua comandi arbitrari, e non c'è nessuna scrittura: nessun pull, nessun commit, nessun push. Il punto interessante, però, è come sono costruiti i tre strumenti di storia, perché è lì che di solito si aprono i buchi. Non basta «non esporre un tool per il push»: git è un programma solo, che fa mille cose diverse a seconda di come lo chiami.
La regola che abbiamo adottato è che i sottocomandi ammessi siano elencati uno per uno, invece di elencare quelli vietati — una lista di divieti è sempre incompleta, e basta dimenticarne uno. Nessuna richiesta passa mai attraverso una shell, quindi non c'è una riga di comando in cui infilare qualcosa. E i riferimenti a commit o tag che arrivano dall'esterno vengono esaminati prima di essere usati, perché un nome di revisione che comincia con un trattino è un'opzione travestita, ed è il trucco più vecchio del mestiere.
Lo stesso vale per i percorsi, che è la parte meno affascinante e la più importante. Qualunque percorso arrivi dall'esterno viene risolto fino in fondo, seguendo eventuali collegamenti, e se il risultato finisce fuori dai repository consentiti la richiesta viene rifiutata. Non conta come è scritto il percorso: conta dove atterra davvero. Un collegamento a metà albero che punta fuori dal codebase non apre nessuna porta.
Tetti su tutto, per un motivo diverso dalla sicurezza
C'è una seconda famiglia di limiti, e non protegge la macchina: protegge l'agente. Una lettura restituisce al massimo qualche centinaio di righe, una ricerca poche decine di risultati, l'albero si ferma a pochi livelli di profondità, la storia a una manciata di commit; e ogni operazione che dura troppo viene interrotta.
Il motivo è che il contesto di un modello è una risorsa scarsa quanto la memoria di una macchina, e uno strumento che può restituire un file intero prima o poi restituirà un file intero, bruciando in un colpo solo lo spazio che serviva al ragionamento. Con i tetti, il modo economico di lavorare diventa anche l'unico possibile: prima ti orienti, poi cerchi, poi leggi una finestra stretta intorno a quello che hai trovato. È esattamente la procedura che raccomandiamo all'agente nella descrizione degli strumenti, e i limiti la rendono obbligatoria anche quando l'agente si distrae.
Vale la pena dirlo esplicitamente: i dati non sono in tempo reale. L'agente legge una copia aggiornata ogni poche ore, e ha uno strumento apposta per sapere quanto è vecchia. Per capire da dove nasce un bug va benissimo; per verificare se una modifica di dieci minuti fa ha risolto qualcosa, no. È un compromesso accettato, non una dimenticanza.
Cosa ci ha insegnato
La cosa che ci portiamo dietro è che, quando si dà accesso a un agente, la domanda giusta non è quali strumenti esporre. Quella è la parte facile, e si risolve con una lista come quella qui sopra. La domanda giusta è cosa succede se uno di quegli strumenti viene usato in un modo che non avevamo previsto, e l'unica risposta che regge è che i limiti stiano sotto l'applicazione: un utente di sistema senza permessi di scrittura, un filesystem in sola lettura, una macchina su cui non c'è nient'altro da prendere.
Tutto il resto — i sottocomandi elencati a mano, i riferimenti controllati prima dell'uso, i percorsi risolti fino in fondo — è buona ingegneria, e serve. Ma è la seconda linea. La prima è che, anche sbagliando tutto il codice, quel processo non ha comunque modo di scrivere niente.